実験2のスキップ率は、著者ら自身の基準に届いていない
「AIを10分使うと根気が落ちる」を転送する前に、実験2の正答率とスキップ率を書き出す。
下のメッセージは、転送されがちな一文を見せるための作例だ。この文面を送った学習グループは、この記事の中にない。
試験勉強のグループに、こんな転送が届く。「Berkeley が証明した。AI の道具を10分使うだけで、続ける力が落ちる。今週は、宿題中にアシスタントを開くのを禁止する。」送り主は論文を付けていない。返信の前にすることは、その研究を開き、著者らがより問題の少ないほうだと扱う実験について三行書くことだ。一週間の勉強の決まりを、転送の一文で書き換えない。
その話は、2026年10月9日の Berkeley News を指している。ニュースは、研究グループが、AI の道具に約10分頼ると、難しい作業への集中と根気が下がると見たと書いている。ランダム化試験の参加者は1,222人、最初の実験は分数を解く354人、より大きい実験は667人、読解の実験は201人、とも書いている。それはニュースの語り方だ。論文は arXiv の 2604.04721 として公開され、実験2をニュースより厳しく語っている。
実験2の三つの数字
実験2は、Prolific を通じて、当時アメリカにいた667人を集めた。Prolific は、オンラインの調査に答える人へ報酬を払うサービスだ。一人あたり3.40米ドル。著者らは所要をおおよそ15分と見積もっている。この金額は、アメリカにいる参加者への報酬だ。ベトナムでも、ほかのどこでも、ソフトの価格ではない。
全員が分数を解く。最初は一段階だけの三問で、アシスタントはない。そのあと一方の群には GPT-5 の横欄が付く。OpenAI のモデルで、問題と解答がすでに入っているので、答えをくれと打てば解答が返る。もう一方には、そのアシスタントがない。それからアシスタントは消され、両群が同じ最後の三問を解く。参加者は問題を飛ばせる。誤答でもお金を引かれないと伝えられていたので、著者らは飛ばすボタンを、正解か不正解かとは分けた「続けない」の印に使っている。
注意を見ているかの確認を通らなかった人と、最初の易しい三問で一問も正解しなかった人を除くと、585人が残る。アシスタントがあった人は308人、なかった人は277人。除外の割合は近く、11.7% と 12.9% だ。著者らはこれを、実験1の欠陥に対処するために書いている。最初の実験では、人を除く仕方によって、基本の分数ができないのに機械の出した答えを提出した人が、アシスタントの群に残り得た。
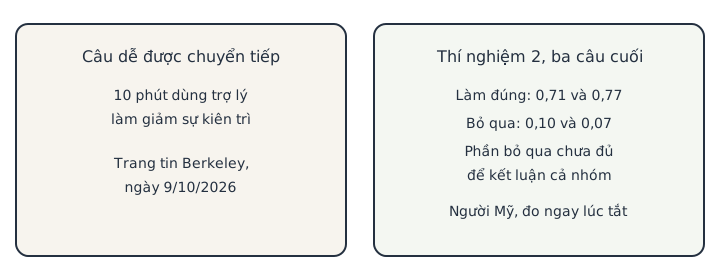
実験2の最後の三問では、アシスタントがあった群の正答の平均は0.71、使っていなかった群は0.77だった。著者らは、この差が、統計的に意味があると呼ぶときに使う基準を超えたと報告している(p = 0.020)。飛ばした割合は0.10に対して0.07。群全体の飛ばしについては、著者らは差がその基準に届かなかったと書いている(p = 0.239)。
Berkeley News は、この大きい群を、アシスタントを外すと間違えたり、すっかり諦めたりし、使わなかった群は最後まで続けて、よりうまくいった、と描いている。その文はニュースの語りだ。論文では、実験2の群全体について「諦めた」部分は、結論するには足りない。アシスタントを切った直後に正答が下がった部分は、著者らが残している。
実験1は、除外のあと307人で、正答の割合が0.57に対して0.73、飛ばした割合が0.20に対して0.11だった。その標本の切り方への注意を付けているのは、著者ら自身だ。ニュースにある354は、著者らがのちにきれいではないと扱う除外の前に、最初に集めた人数だ。
答えをもらうことと、一歩だけ聞くことは違う
実験2の終わりに、アシスタントの群は使い方を自分で申告した。189人、つまり61%が、主に答えを求めたと言った。82人、27%が、ヒントか説明を求めたと言った。37人、12%が、使わなかったと言った。使わなかったと言う群について、著者らは申告とチャットの記録を照合している。その群の多くは、ほとんどメッセージを送っていなかった。
最後の三問で、答えを求めたと申告した人たちの正答の平均は0.65で、アシスタントがなかった群の0.77と比べている。答えを求めた人たちの飛ばした割合は0.13に対して0.07で、著者らはこの差が基準を超えたと報告している(p = 0.033)。ヒントを求めた人たちの正答の平均は0.76で、アシスタントがなかった群に近い。
著者らは、この分析が、すでにアシスタントの群にいた人たちを横断して切ったものだと、はっきり書いている。差がどこにあるかを示す。答えを求めたことが飛ばしを引き起こした証明にはならない。使い方は本人が選んでおり、「答えだけ頼んでよい」「ヒントだけ頼んでよい」のどちらかに、無作為で割り当てられてはいない。
実験3は読解に移り、ネット上の無料の SAT 練習問題から項目を取っている。SAT は、アメリカの大学入試で使われる共通試験だ。これは本番の問題ではない。残った標本は168人。アシスタントがあった群の正答の平均は0.76に対して0.89、飛ばしは0.08に対して0.01。この実験では、著者らは両方の差が基準を超えたと報告している。五秒未満の回答も飛ばしに数えている。文章を読む時間がなかったからだ。だから「やめやすい」は、この読解でははっきり出て、実験2の分数について群全体をまとめたときには、はっきり出るほどではない。
論文の冒頭近くには、限界の一文がある。著者らは、結果を、AI のアシスタントがあらゆる作業で根気と、助けなしにやる力を下げるという広い証拠として読まないよう勧めている。一般向けの要約は、その効果が何日も積み重なれば懸念だ、と述べている。それは、彼らが測っていないことだ。セッションは、アシスタントを切った直後で終わっている。
グループへ返す文
返信に足りるのは三行だ。
こう書ける。より問題の少ない実験が測っているのは、アシスタントを切った直後で、アメリカにいる大人が実験用の分数を解く場面だ。自分のクラスの一週間は測っていない。アシスタントがあった群の全体は、最後の三問の正答が低かった。0.71に対して0.77。その群全体の飛ばし、0.10に対して0.07は、著者らがまだ結論できる差としては扱っていない。飛ばしが高いのは、答えを求めたと申告した人たちで、論文はその切り分けを因果の証拠にしていない。
できあがった答えをアシスタントに頼む勉強をしているなら、今週の変え方は禁止より狭い。次の問題では一歩だけ聞き、アシスタントの欄を閉じたあと、次の一行を自分で書く。ニュースの一文は、アシスタントを10分開くたびの禁止令には足りない。ニュースも論文も、あなたの学習の予定は測っていない。
メッセージが「ベトナムの生徒は根気が落ちたと証明された」、あるいは「自分のクラスの生徒がそうだと証明された」と言うなら、その文は二つの出典にない。標本は、アメリカにいる参加者だ。
Sources
- Liu, Christian ほか — AI Assistance Reduces Persistence and Hurts Independent Performance, arXiv:2604.04721 — 三つの実験の設計、除外後の標本、実験2と3の正答の割合と飛ばした割合、答えを求めたと申告した割合、あらゆる作業の証拠ではないという限界。
- Berkeley News、2026年10月9日 — Using AI for just 10 minutes erodes your ability to persist at hard things — 大学のニュース記事。10分という文、合計1,222人、実験を354人、667人、それから201人と語る部分。